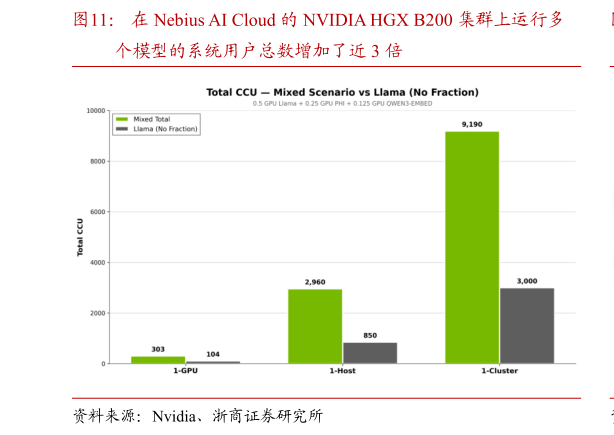
> 数据图表请问一下在 Nebius AI Cloud 的 NVIDIA HGX B200 集群上运行多
2026-9-03) 多模型混合部署:在 GPU 上部署了 0.5 个 GPU 的 Llama 3.1 8B、0.25 个 GPU 的Phi-4 Mini 和 0.125 个 GPU 的 Qwen-Embeddings。可同时运行推理的用户总数增加了近 3倍,满负荷运行时总吞吐量超过 35 万 TPS。验证了 NVIDIA Run:ai 调度器能够打包异构推理工作负载,而不会影响延迟或利用率。而传统 K8s 原生调度无法实现多模型混合部署。