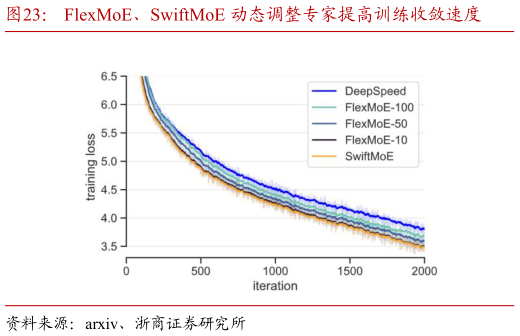
> 数据图表各位网友请教一下FlexMoE、SwiftMoE 动态调整专家提高训练收敛速度2026-9-0训练损失曲线显示,DeepSpeed 静态基线收敛最慢,FlexMoE 各变体均优于 DeepSpeed,且重平衡间隔越小收益越高,而 SwiftMoE 在全部方案中收敛最快。与之对应,token 留存率指标呈现相同排序:DeepSpeed 的 token 留存率最低,大量输入因热点专家容量溢出被直接丢弃FlexMoE 通过周期性重平衡有效降低了 token 丢弃比例SwiftMoE 则凭借实时自适应副本调度实现最高的 token 留存水平。浙商证券综合其他