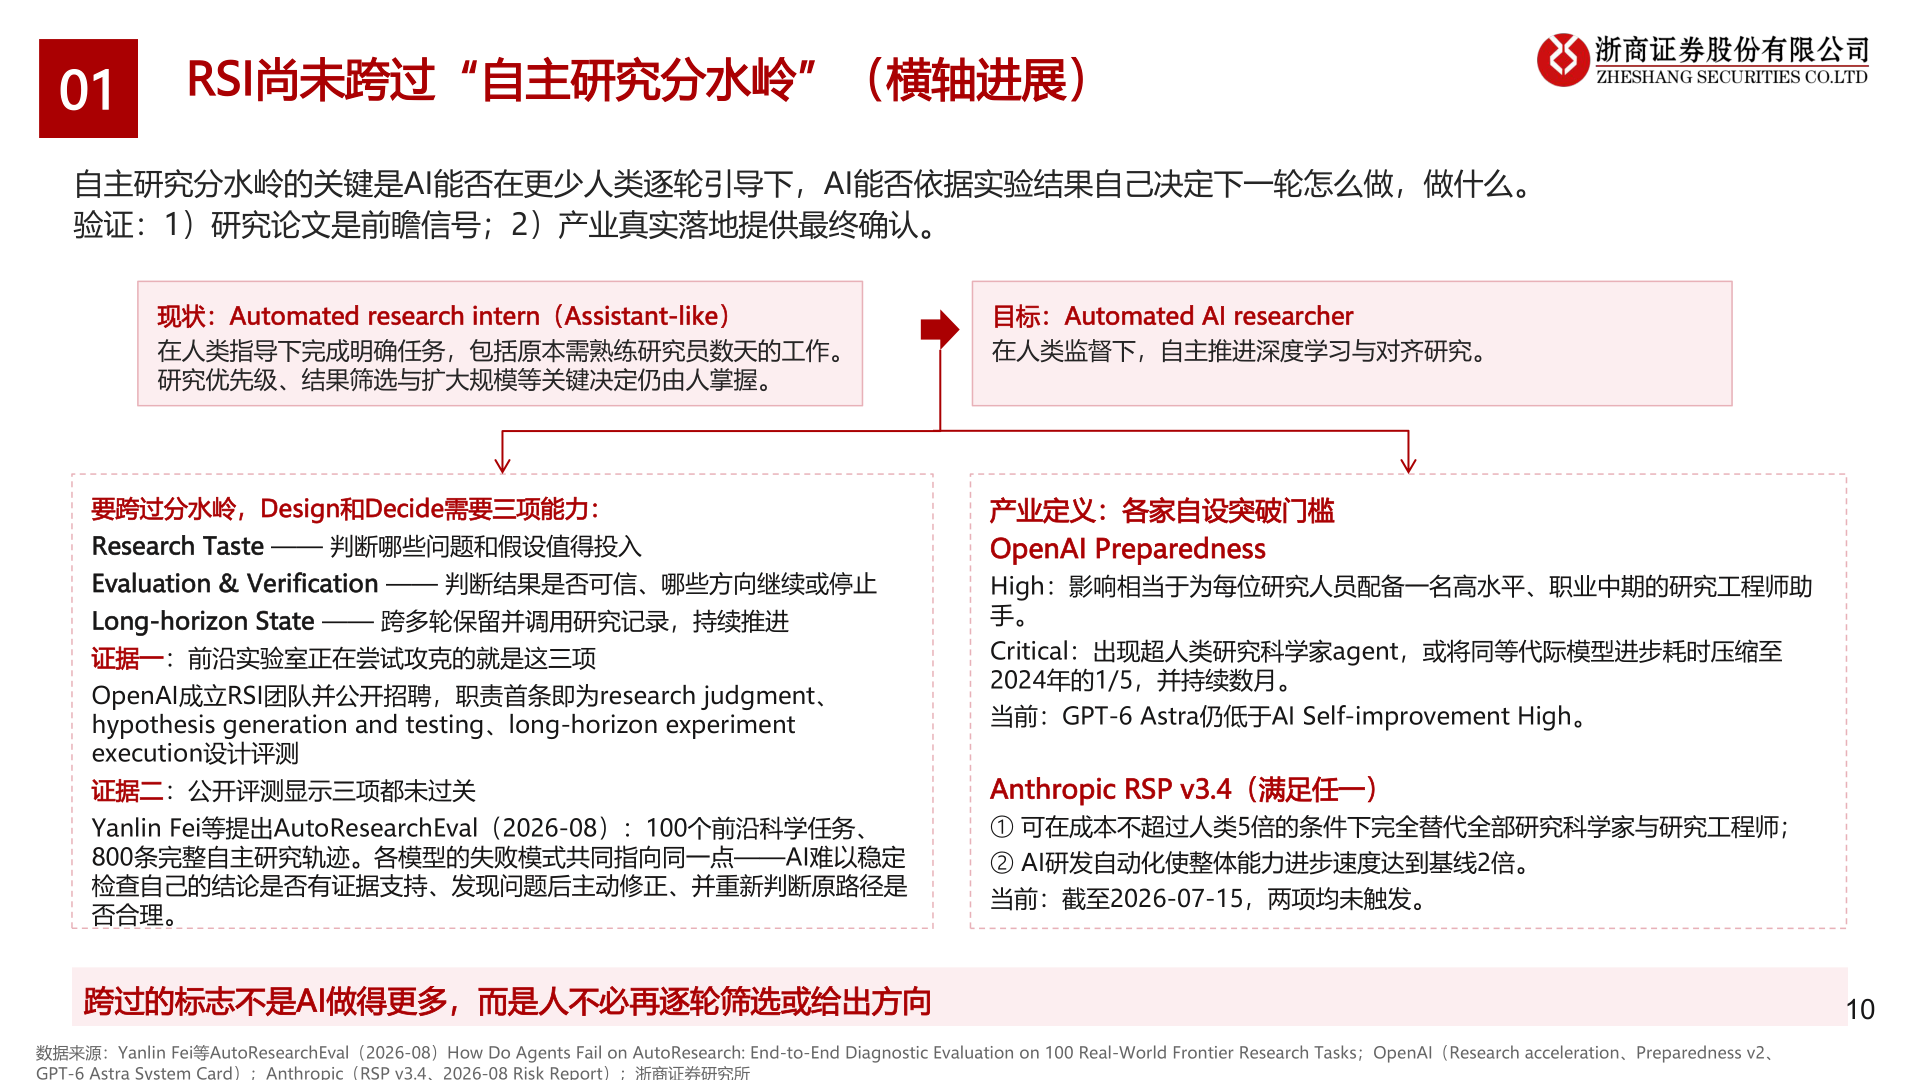
> 数据图表怎样理解012026-9-201RSI尚未跨过“自主研究分水岭”(横轴进展)自主研究分水岭的关键是AI能否在更少人类逐轮引导下,AI能否依据实验结果自己决定下一轮怎么做,做什么。验证:1)研究论文是前瞻信号;2)产业真实落地提供最终确认。现状:Automated research intern(Assistant-like)在人类指导下完成明确任务,包括原本需熟练研究员数天的工作。研究优先级、结果筛选与扩大规模等关键决定仍由人掌握。目标:Automated AI researcher在人类监督下,自主推进深度学习与对齐研究。要跨过分水岭,Design和Decide需要三项能力:Research Taste —— 判断哪些问题和假设值得投入Evaluation & Verification —— 判断结果是否可信、哪些方向继续或停止Long-horizon State —— 跨多轮保留并调用研究记录,持续推进证据一:前沿实验室正在尝试攻克的就是这三项OpenAI成立RSI团队并公开招聘,职责首条即为research judgment、hypothesis generation and testing、long-horizon experiment execution设计评测证据二:公开评测显示三项都未过关Yanlin Fei等提出AutoResearchEval(2026-08):100个前沿科学任务、800条完整自主研究轨迹。各模型的失败模式共同指向同一点——AI难以稳定检查自己的结论是否有证据支持、发现问题后主动修正、并重新判断原路径是否合理。产业定义:各家自设突破门槛OpenAI PreparednessHigh:影响相当于为每位研究人员配备一名高水平、职业中期的研究工程师助手。Critical:出现超人类研究科学家agent,或将同等代际模型进步耗时压缩至2024年的1/5,并持续数月。当前:GPT-6 Astra仍低于AI Self-improvement High。Anthropic RSP v3.4(满足任一)① 可在成本不超过人类5倍的条件下完全替代全部研究科学家与研究工程师;② AI研发自动化使整体能力进步速度达到基线2倍。当前:截至2026-07-15,两项均未触发。跨过的标志不是AI做得更多,而是人不必再逐轮筛选或给出方向10数据来源:Yanlin Fei等AutoResearchEval(2026-08)How Do Agents Fail on AutoResearch: End-to-End Diagnostic Evaluation on 100 Real-World Frontier Research Tasks;OpenAI(Research acceleration、Preparedness v2、GPT-6 Astra System Card);Anthropic(RSP v3.4、2026-08 Risk Report);浙商证券研究所浙商证券综合其他