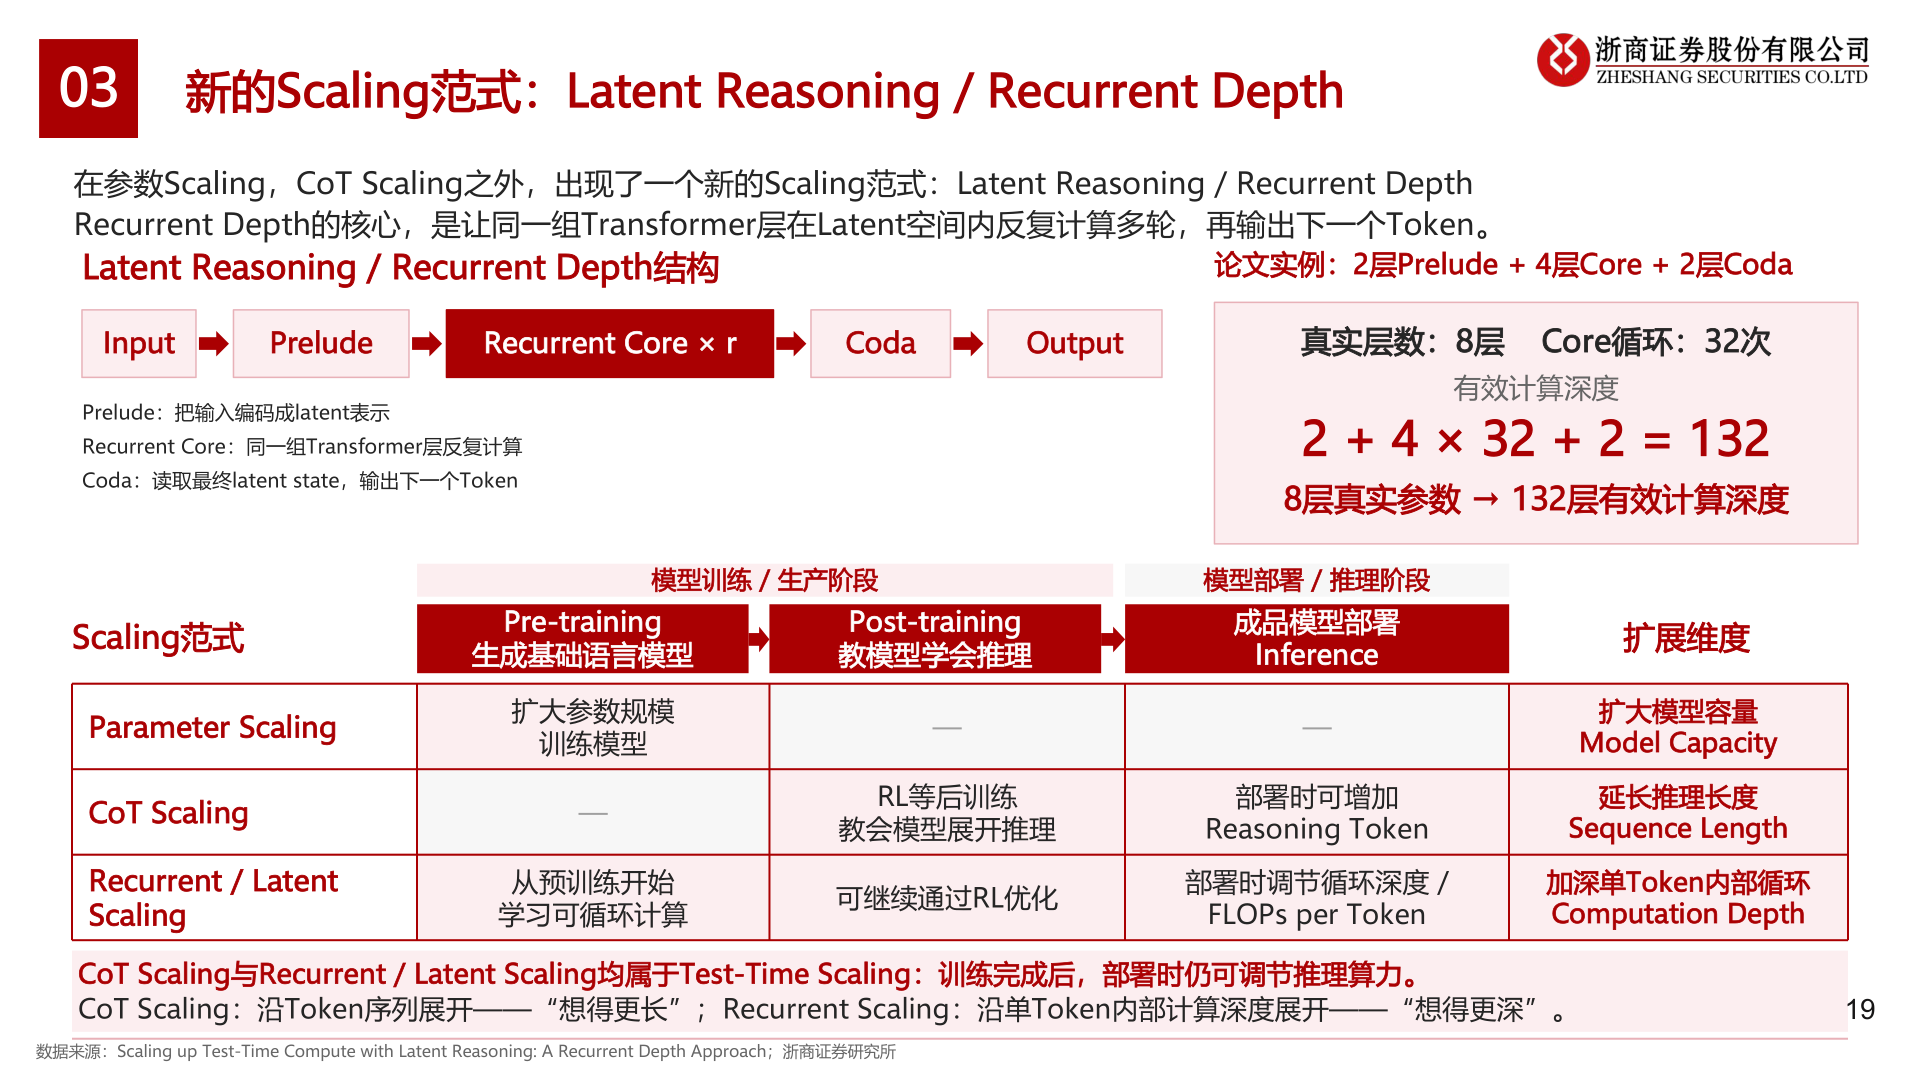
> 数据图表我想了解一下03 新的Scaling范式:Latent Reasoning / Recurrent Depth2026-9-203 新的Scaling范式:Latent Reasoning / Recurrent Depth在参数Scaling,CoT Scaling之外,出现了一个新的Scaling范式:Latent Reasoning / Recurrent DepthRecurrent Depth的核心,是让同一组Transformer层在Latent空间内反复计算多轮,再输出下一个Token。Latent Reasoning / Recurrent Depth结构论文实例:2层Prelude + 4层Core + 2层CodaInputPreludeRecurrent Core × rCodaOutput真实层数:8层 Core循环:32次Prelude:把输入编码成latent表示Recurrent Core:同一组Transformer层反复计算Coda:读取最终latent state,输出下一个Token模型训练 / 生产阶段Scaling范式Parameter ScalingCoT ScalingRecurrent / LatentScalingPre-training生成基础语言模型扩大参数规模训练模型—从预训练开始学习可循环计算Post-training教模型学会推理RL等后训练教会模型展开推理可继续通过RL优化——有效计算深度2 + 4 × 32 + 2 = 1328层真实参数 → 132层有效计算深度模型部署 / 推理阶段成品模型部署Inference部署时可增加Reasoning Token扩展维度扩大模型容量Model Capacity延长推理长度Sequence Length部署时调节循环深度 /FLOPs per Token加深单Token内部循环Computation DepthCoT Scaling与Recurrent / Latent Scaling均属于Test-Time Scaling:训练完成后,部署时仍可调节推理算力。CoT Scaling:沿Token序列展开——“想得更长”;Recurrent Scaling:沿单Token内部计算深度展开——“想得更深”。19数据来源:Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach;浙商证券研究所浙商证券综合其他