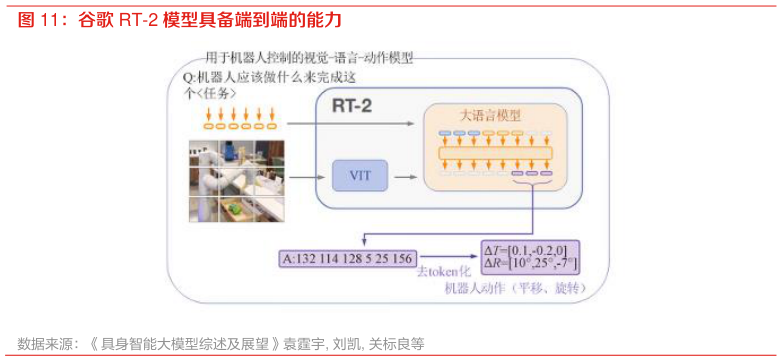
> 数据图表如何解释谷歌 RT-2 模型具备端到端的能力2026-8-5谷歌在端到端 VLA 模型上技术积淀深厚,其最新发布的 Gemini Robotics 2 已能实现对人形机器人的全身控制。谷歌 RT-1 首次将 Transformer 架构引入低维机器人控制任务,实现了图像、语言与动作的端到端建模,揭示了统一多模态输入达到动作输出的可能性。随后发布的 RT-2 更进一步融合了 CLIP 等大规模视觉语言预训练模型,赋予了机器人从互联网上迁移跨模态知识的能力,显著提升了模型在开放环境下的泛化控制能力。 RT-2 的关键创新在于提出“动作语言化”Action-as-Language范式:将连续的机器人动作离散化为若干词元,使其与语言序列统一到相同的建模空间,这使得模型能够利用 VLM 的强大能力来生成语言,同时也可将动作视为一种特殊的语言表达形式进行处理。近期,谷歌发布了 Gemini Robotics 2 新模型,与此前主要控制机器人上半身动作的模型不同,Gemini Robotics 2 能够实现对人形机器人全身的控制。谷歌同时推出了具身推理模型 Gemini Robotics ER 2,相较 Gemini Robotics ER 1.6,ER 2 可分析连续视频流,机器人可据此跟踪自身任务进度,在动作出错时调整或重试,并判断何时进入下一步骤。东方证券综合其他