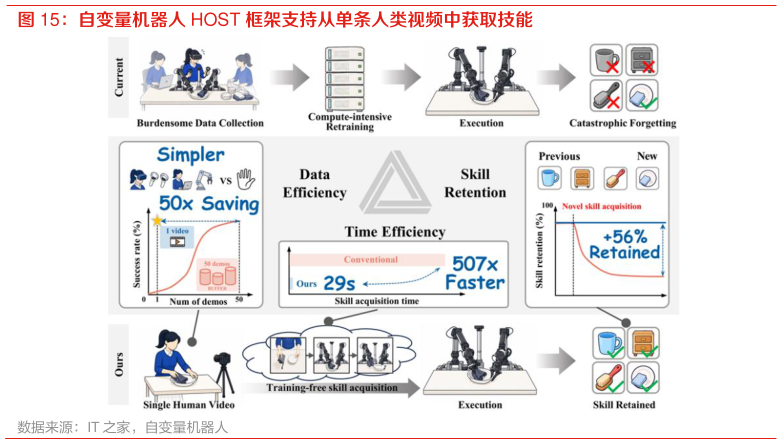
> 数据图表如何了解自变量机器人 HOST 框架支持从单条人类视频中获取技能
2026-8-5互联网多模态数据有望广泛用于具身模型预训练,以提升具身模型的泛化能力。与文本数据类似,互联网也拥有海量的视频数据,其中包含人类动作的视频也具有演示作用。人类视频演示学习是一种新兴的机器人学习方法,核心是利用人类视频演示作为知识来源,使机器人理解并模仿人类行为来完成复杂任务,无需手动编程或大量的机器人数据采集。我们认为互联网多模态数据是整机厂商之间共同的原始数据源,其使用的核心更在于筛选、处理和训练,并且互联网数据相较于仿真数据而言丰富度更高,同样有望助力初创整机厂商弥补真机数据积累的不足,实现模型的突破。例如千寻智能注重互联网数据的使用,其训练 VLA 模型会先让模型学习海量互联网数据,包括文本、图像和视频等,从而获取通用常识和基础能力。之后引入真机的遥操作数据来进行精细的 SFT(监督微调),提升模型在实际任务中的表现,最后通过强化学习进一步优化操作的成功率。近期,自变量机器人发布并开源 HOST 框架,该框架让机器人仅观察一段数十秒的人类视频即可学会新技能,同时保留已掌握的技能。根据自变量披露的数据,机器人从一段 29 秒的人类视频中学习技能的成功率为 62%,超越零样本基线 45%,相比 Pi-0.5微调方案,所需数据量为原来的 150,学习速度提升 500 倍。