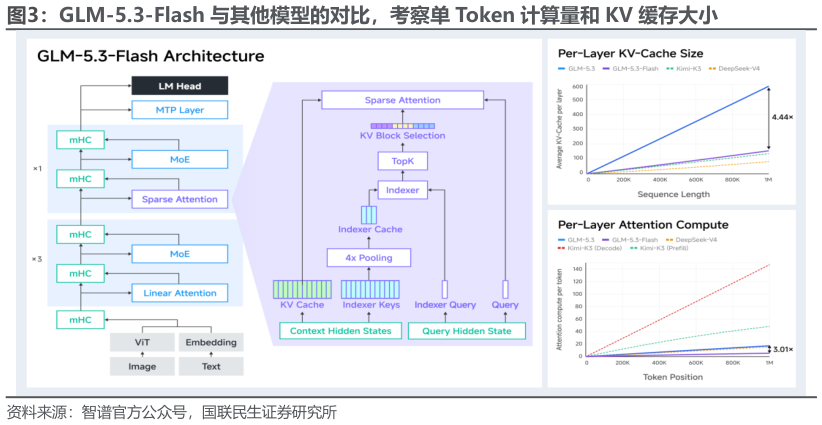
> 数据图表想关注一下GLM-5.3-Flash 与其他模型的对比,考察单 Token 计算量和 KV 缓存大小2026-9-6度压缩上下文,结合 DSA 稀疏注意力,1M 上下文成为全系服务标配。稀疏线性注意力将注意力计算的显存与带宽需求大幅压缩,缓解显存消耗与带宽压力。国联民生证券综合其他