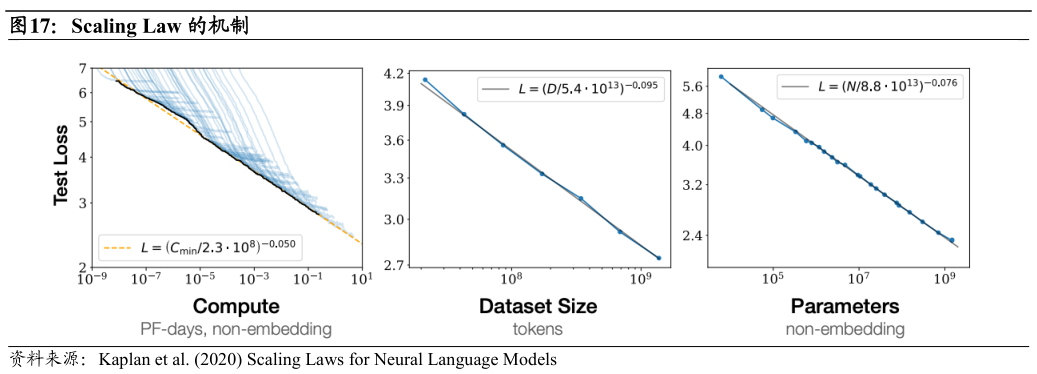
> 数据图表想问下各位网友Scaling Law 的机制2026-9-42.1. 长上下文、推理与多模态能力提升 Transformer 架构与 Scaling Law 推动大模型能力提升。大语言模型通过大规模文本和代码训练,学习语言规律并根据上下文生成内容。Transformer 的注意力机制提高了并行训练效率,使模型能够扩展至更大的参数和数据规模Scaling Law 则表明,增加参数、训练数据和算力通常可以继续降低模型损失。海外头部厂商由此持续扩大训练投入,推动模型理解和生成能力提升。国泰海通综合其他