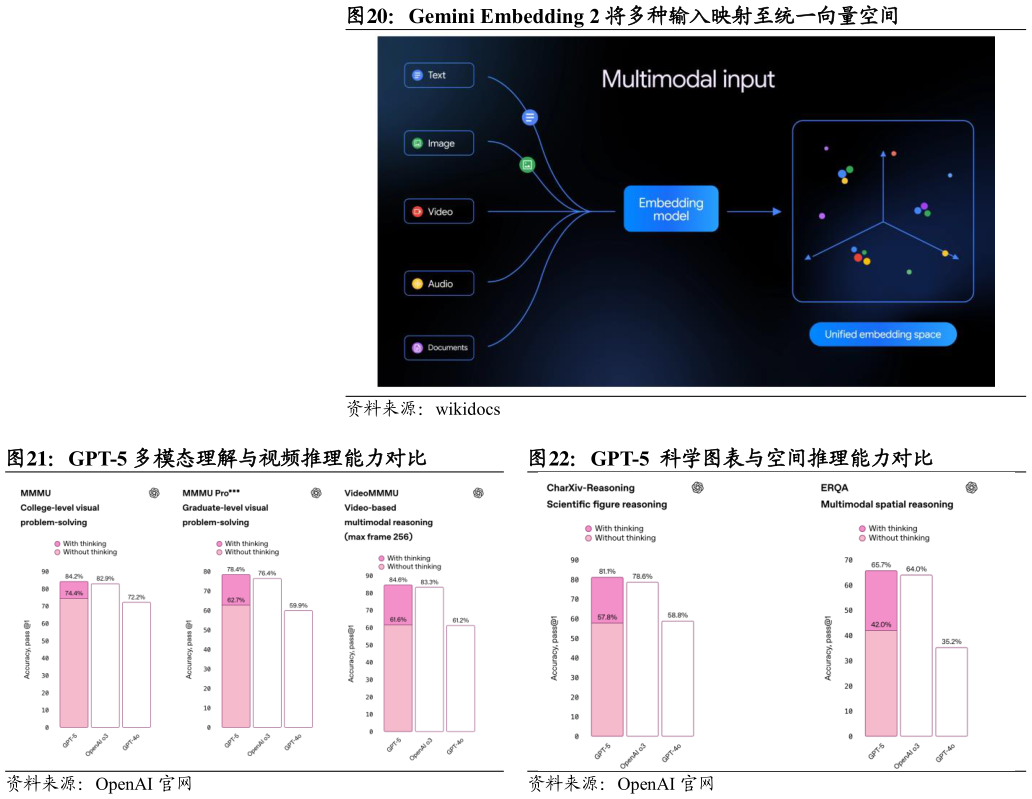
> 数据图表如何解释Gemini Embedding 2 将多种输入映射至统一向量空间 GPT-5 多模态理解与视频推理能力对比2026-9-4多模态模型由单一内容识别升级为跨模态理解与检索。GPT-4o 在同一模型中处理文本、音频、图像和视频输入,并支持文本、音频和图像输出,音频响应最快为 232 毫秒、平均为 320 毫秒GPT-5 进一步提升视觉问题求解、视频理解、科学图表和空间推理能力,MMMU 得分达到 84.2%。Google 则将多模态能力用于企业信息检索,Gemini Embedding 2 可把文本、图片、视频、音频和文档映射至统一向量空间,覆盖 100 多种语言,支持跨模态搜索、分类和聚类。 多模态能力提升工作效率,进一步赋能内容产业链。多模态模型可统一处理文本、图像、音频和视频等信息,使各项多模态任务可以在同一产品内连国泰海通综合其他