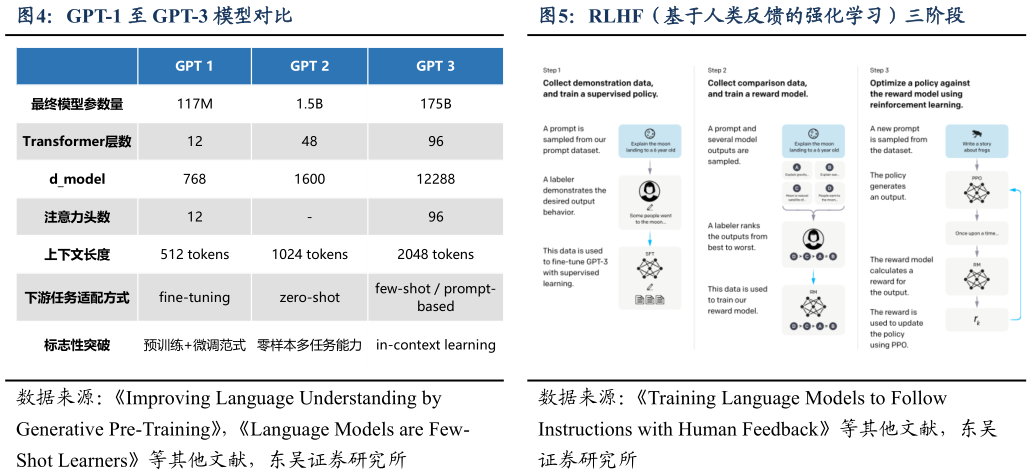
> 数据图表请问一下GPT-1 至 GPT-3 模型对比RLHF(基于人类反馈的强化学习)三阶段2026-8-3预训练模型基础上引入人工示范、人工偏好数据与 RLHF,使模型输出更贴合人类意图,形成 SFT奖励模型强化学习(PPO)的经典三阶段流程。东吴证券综合其他