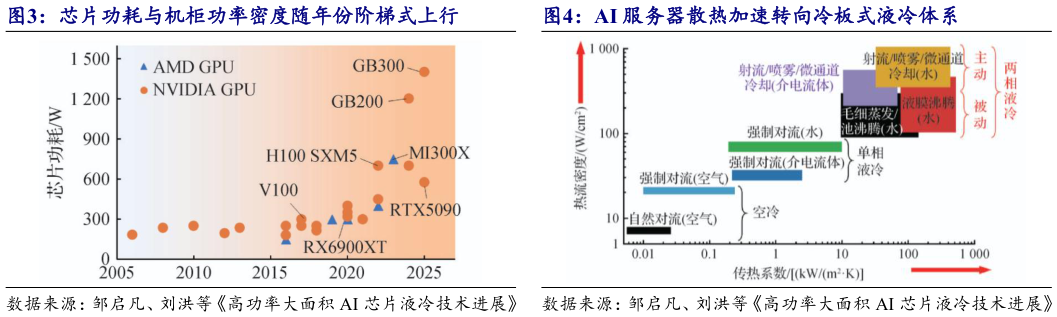
> 数据图表如何了解芯片功耗与机柜功率密度随年份阶梯式上行AI 服务器散热加速转向冷板式液冷体系2026-10-0大模型算力需求的快速扩张,叠加制程微缩能效红利的持续衰减,共同推动芯片功耗与机柜功率密度迈入长期上行通道。一方面,大模型参数量由千亿级迈向万亿级,训练算力呈数量级增长,推理算力随业务并发与上下文规模同步扩张而单芯片依靠微缩制程提升能效的空间日益收窄,芯片厂商通过扩大芯片面积、增加晶体管规模、优化架构缓存并适度提升运行频率来提升算力,单芯片功耗随之由数百瓦迈入千瓦级另一方面,为缩短集群内部互联距离、提升带宽利用率,算力部署由单机向整机柜、超节点演进,加速卡数量与集成密度持续提高,单机柜功耗密度同步跃升至百千瓦量级。两大动因相互强化,使芯片功耗与机柜功率密度形成共振上行,并持续逼近风冷散热的物理承载极限。随着芯片功耗与机柜功率密度的阶梯式上行,AI 服务器散热加速转向冷板式液冷体系。单 GPU 功耗已由 GB200 的 1200W 升至 GB300 的 1400W,随着 AI 服务器往 Rubin 等更加先进的架构演进,单机柜部署功率密度逐渐突破 100kW,而行业内风冷散热的能力边界通常被认定在单机柜 40 至 60kW,芯片功率超过 300W 后传统风冷散热能力即告失效。在冷板式、浸没式等技术路线中,冷板式液冷与既有数据中心基础设施架构及运维模式兼容性最高,改造无需对服务器主板形态做重大变更,因此成为高密度算力建设的默认配置。开源证券综合其他